机器人学不会叠衣服 人类正在收学费
作者:Thejaswini M A 来源:Token Dispatch 翻译:善欧巴,金色财经
我们常把「知道某件事」和「能把它讲出来」混为一谈。只要一个人能把知识诉诸语言,我们就会认可他的专业能力。
系鞋带这件事,你几乎不用过脑子。但要向别人解释每一根手指该怎么动,就变得既困难又混乱。你明明会做,却很难说清楚。
AI 让这个难题有了商业价值。人们能轻松讲出来的知识,大多已经躺在书本或互联网上。而要获取那些只能通过「动手」体现出来的知识,就需要完全不同的安排:得有人去说服他们演示一遍,并把过程中的足够多信息记录下来,还要判断机器能不能从这些结果里学到东西。
一个过去很少被认可的知识市场正在浮现。但这是否意味着,掌握这些知识的人就能卖个好价钱?
物理 AI 还是个新生儿:有点吵、有点天真、基本上什么都不懂。它们急需大量关于琐碎日常的信息,又没有几年时间去慢慢建立自己的成长曲线。眼下就得拿到。
围绕这一过程的各个环节,已经有公司在搭建生意。随之而来的问题是:当人类经验变成训练材料之后,它到底归谁所有。
今天我们看的,是那些教 AI 怎么叠一件 T 恤的公司,以及这门生意的可持续性。
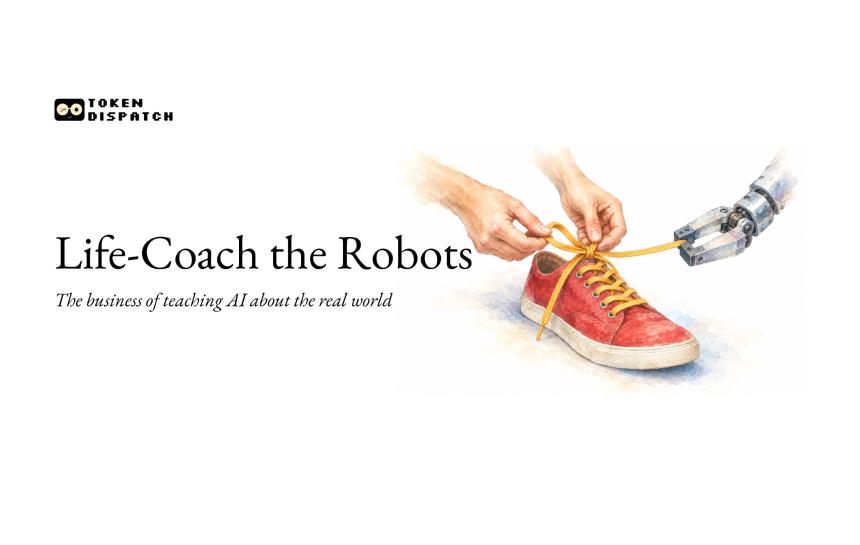
1988 年,机器人专家汉斯·莫拉维克(Hans Moravec)在《心智儿童》(Mind Children)一书中指出:让计算机在智力测试或跳棋上表现得像成年人,相当容易;而要让一台机器拥有一个一岁小孩的感知和运动能力,几乎不可能。
这后来被称为「莫拉维克悖论」。
2025 年 7 月,Google DeepMind 和 OpenAI 的系统在国际数学奥林匹克竞赛中达到了金牌水平。与此同时,机器人公司仍在发布机器人叠 T 恤的视频,以此作为技术进步的证明。
人类是怎么叠 T 恤的?
把布平铺在桌上,用手抹平褶皱。捏起离你最近的两个角,送到对侧的两个角上。一起放下。再抹平一次,然后对折一回。叠好了。
你不用看就能找到角落。你知道自己抓到的是一层布还是两层。如果你发现一只袖子翻了过来,抖一抖就正过来了。这些步骤从来没人写下来,因为没人需要写。
Physical Intelligence 联合创始人切尔西·芬恩(Chelsea Finn)曾描述过一个早期的洗衣模型:在一组受控的衬衫上表现良好,但遇到混杂堆放的一堆衣服就失败了。
这正是人们现在花钱去解决的问题。语言模型背后是互联网上堆积如山的文字,这些文字为其他目的而产生,抓取起来毫不费力。加州大学伯克利分校机器人专家肯·戈德堡(Ken Goldberg)估算,训练当今大型视觉语言模型所用的文本和图像,如果换算成时间,大约相当于十万年的人类经验。而在体力劳动这个领域,机器人手里什么都没有。YouTube 上到处都是做饭和打扫的视频,但视频只展示双手长什么样,不会告诉你握得多紧,也不会告诉你机器人自己的摄像头和关节会读到什么。
举个例子,瓶盖有那么多类型。每一种的打开方式都有教程视频吗?要施多大劲、往哪个方向拉或者拧?有课程吗?没有。
2025 年年中,特斯拉把 Optimus 的训练重心转向主要依靠视频。一位外部研究者当时就指出,这种做法缺少了对触觉和接触的感知。
仿真有帮助,但并不总是有效。比如布料,你每碰一次它就变一个形状。在 2024 年的一项研究中,研究者只用合成图像训练系统去找毛巾和 T 恤的角点,精度达到 64%,用真实照片微调后升到 74%。作者们的结论是:模拟出来的布料还需要逼真得多才行。合成数据同样需要一个「裁判」——仿真器能生成一百万种折法,但哪一种算叠好了,还是得由人来判断。
Kled 花钱雇人,为 AI 公司收集照片、视频和音频。它的 App 会列出任务,比如拍摄某项日常活动,同时给出操作说明和报酬。Kled 审核提交内容,为通过的作品付钱,再把清洗、打包好的数据集转售给训练和优化 AI 模型的公司。Kled 可以在一个人已经站在自家厨房里时给他推送通知;按它的说法,V3 版本已经能把贡献者引导到具体任务上。
9 月下旬,Kled 改了打开 App 后看到的界面。
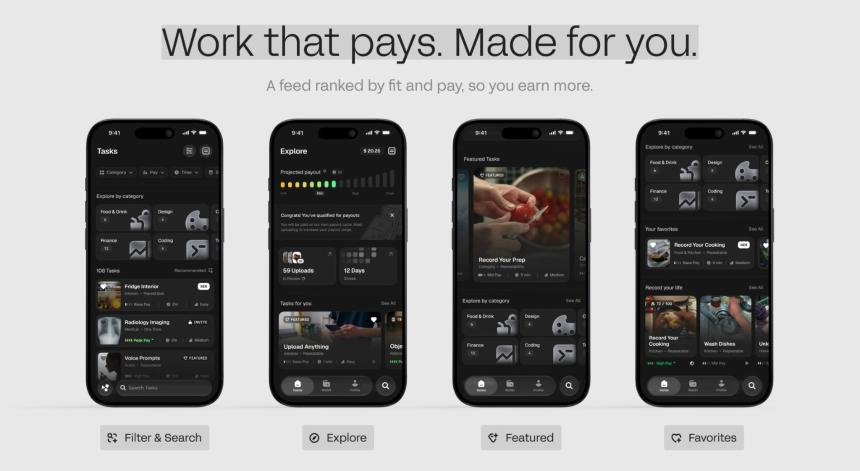
过去首页只有一个大按钮,用来上传相册里已有的东西。新的首页是一个任务信息流,开工之前就能看到报酬。Kled 说,现在它能把这类的需求推送给 50 多万名贡献者,并在 72 小时内开始收到数据。
Kled 隶属于 Nitrility Inc.,这是一家由阿维·帕特尔(Avi Patel)于 2025 年在旧金山创立的公司。你上传文件,Kled 付钱给你,再把这些文件清洗、打包成数据集,授权给训练模型的公司使用。
帕特尔曾写道,规模更大的竞争者每 1 美元要抽走大约三分之一。那么他自己抽多少,自然就成了一个该问的问题。
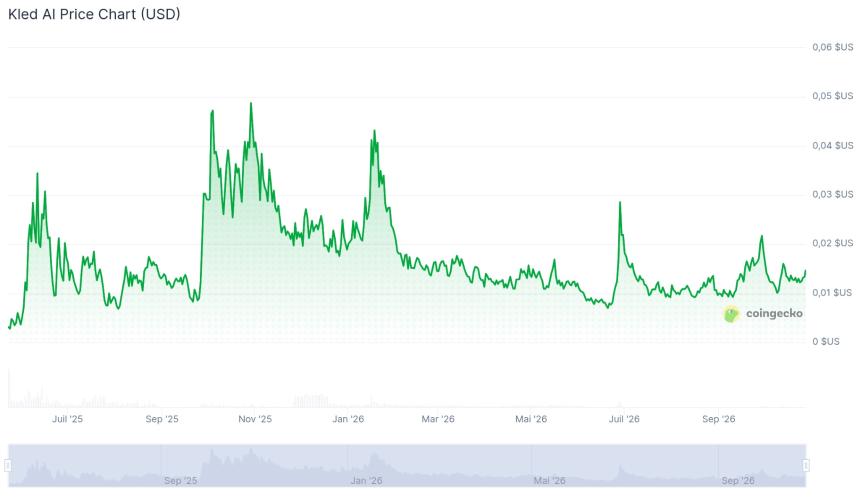
贡献者通过 PayPal、Venmo 或 Solana 钱包以美元结账。Solana 上还有一个 KLED 代币,市值约 1000 万美元。对一个号称拥有 50 万贡献者的网络来说,这个规模很小。KLED 不是股权,持有者对公司的资产没有任何索取权。公司可以自行决定回购代币。Kled 并没有说实验室必须购买这个代币,而且大多数贡献者拿到的是美元。
Kled 声称拥有超过 50 万名贡献者,每天产出约 800 万个数据点。今年早些时候它表示,已累计支付数百万美元,并且管线中已有超过 3000 万美元的买方需求。
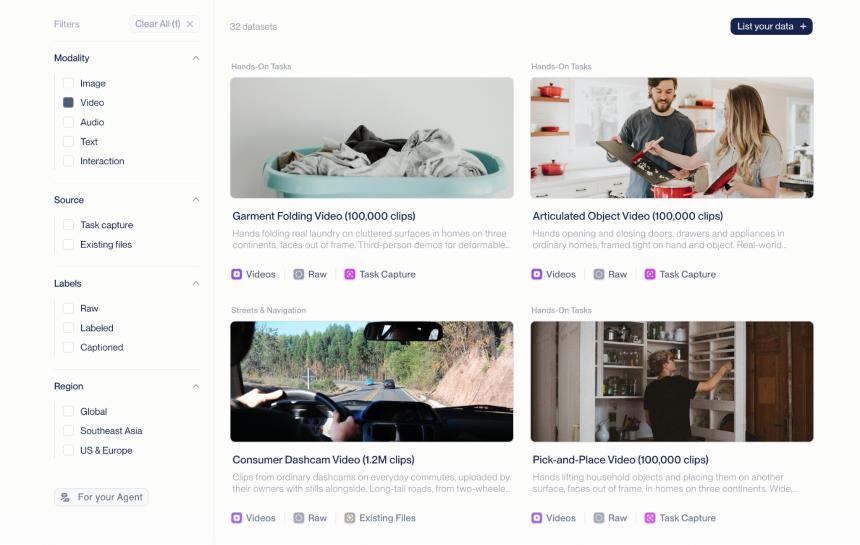
人们到底能赚多少,就更模糊了。App Store 的评论里有人抱怨拍了一百张照片才拿到 1 美元,而 Kled 的回复说报酬并不固定,取决于上传内容的独特程度和买方的需求。Kled 还说过,它收入最高的贡献者一个月大约能挣 7400 美元。
公开材料既没有给出贡献者在客户收入中的标准分成比例,也没有给出可信的平均时薪。
Kled 的条款规定,贡献者保留所有权,但需授予一项永久的、不可撤销的、可转让的许可。该许可在涉及第三方 AI 开发与训练的特定用途上是排他性的。也就是说,保留所有权并不等于你还能把同一份素材授权给另一家 AI 数据买方。条款同时把获取必要授权的责任放在贡献者身上——一段在家里拍的视频,也可能夹带别人的个人信息。
旧金山初创公司 PrismaX 更专注地瞄准机器人训练。2025 年,PrismaX 完成了 1100 万美元融资,由 a16z 的加密加速器领投。
它收集这类数据的方式之一,是让人远程操控一台机器人,这叫做遥操作。操作者可能引导机械臂去拿起一个杯子,放进料箱。任务过程中,系统既录下摄像头画面,也录下机器人的动作。这些记录能帮助模型学会:根据机器人看到的东西,该做哪些动作。
Kled 拍的一段「有人收拾房间」的视频,能展示出涉及了哪些动作。而通过操控机器人得到的记录,还额外捕捉到了驱动机械臂和夹爪的指令。这就让模型获得了视频画面之外、关于机器人如何完成这项任务的信息。
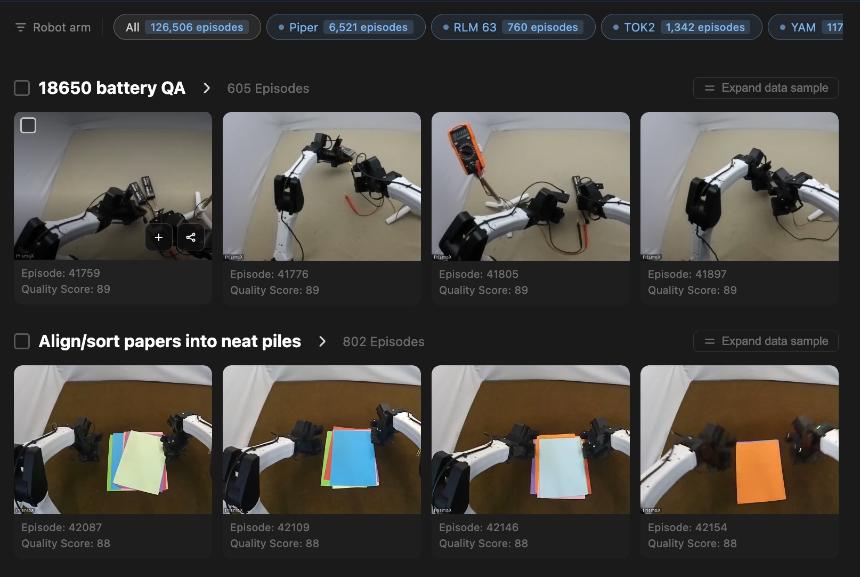
PrismaX 声称已交付超过 12 万个任务片段,具备每月 5000 小时定制数据的产能,并称已向贡献者支付超过 100 万美元。
机器人拥有者用自己的硬件跑任务,按有效场次获得报酬。PrismaX 还在开放第一人称视频收集,为符合其「操作者意图标准」(Operator Intent standard)的片段付费。每次上传都带有产出该数据的那台已注册机器人的序列号,主摄像头画面要经过质量检查和查重。
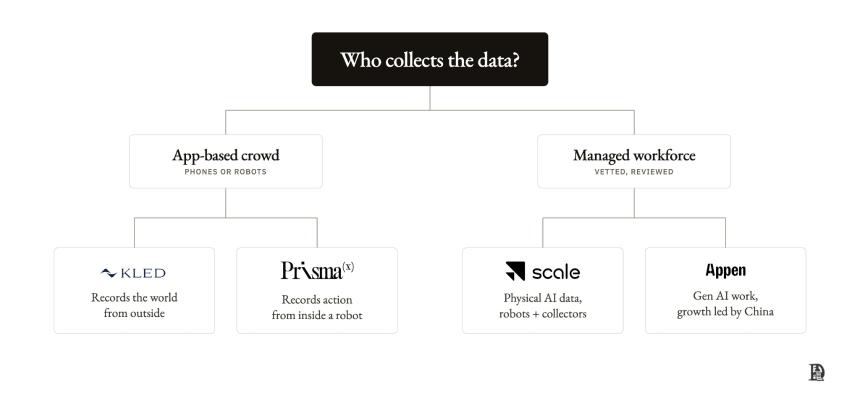
Kled 主要从外部拍摄世界,这种方式便宜且可以批量进行。PrismaX 从机器内部记录动作,速度更慢、成本更高,因为每一场次都需要一台机器人。两家公司也在向对方靠拢:Kled 的 V3 开始征集人们整理房间的第一人称视频,而 PrismaX 的视频候补名单已经接受智能手机拍摄。
这些产品都还在早期,而行业里已经有老牌玩家在做同样的事。
Scale AI 记录人操作机器人完成任务的过程。它还有一个自称「无机器人自我中心平台」的业务,只从人的视角记录任务,完全不用机器人。其客户包括机器人公司 Generalist 和 Physical Intelligence。
2025 年 6 月,Meta 收购了 Scale 49% 的股份。Scale 表示,那一年它交付了超过 15 万小时的物理 AI 数据。其官网称,现在每天从人们的家庭以及商业和工业场所收集超过 1000 小时的演示数据。
Appen 同样在收集人们执行体力任务的录像。它还会补充标注,解释画面里发生了什么,比如人的手如何移动、物体是被拿起还是被放下。这些细节能把一段视频变成机器人可以学习的材料。
Appen 公布 2025 年整体营业收入为 2.308 亿美元,涵盖其全部业务,不只是机器人。其中国以外业务下滑约 21%,而中国市场的增长帮助提升了整体营收。AI 训练需求的上升,并不会让数据供应商业务中的每一块都平等受益。
一些过去熟悉的任务,比如给图像中的物体打标签,现在已经可以部分自动化。与此同时,客户开始购买需要不同技能的工作,比如核查一段法律答复,或者录制一段有用的机器人演示。一家公司可能拥有成千上万名贡献者,却仍然缺少承接新合同所需的人手或设备。
供应商也可能丢掉仍然有价值的工作。2024 年,谷歌终止了与 Appen 的合同,并表示质量评估业务将转给其他供应商。前一年,这个客户为 Appen 带来了 8280 万美元收入。
这对 Kled 和 PrismaX 都很关键。建立一个庞大的贡献者网络,等于手上有人可以调用,但买方需要的是特定类型的数据。它们的前景取决于两点:多快能组织起正确的采集工作,以及能否证明这些数据满足客户需求。
触达更多贡献者,可能会让 Kled 和 PrismaX 的采集更轻松。但它们仍然必须确保录像是有用的。Scale 早就在利用家庭和工作场所采集数据了。这一点已经不是护城河。
连 DoorDash 现在都在付钱给骑手,让他们录制洗碗之类的任务,用于 AI 训练。
更持久的优势,是知道客户的机器人在哪里卡住,并且能可靠地采集到帮助它改进的演示数据。这种认知可以随着每个项目积累——供应商会逐渐明白什么样的录像有用、什么样的贡献者能拍出这种录像。
英伟达的 AdaDemo 研究支持「针对弱点下手」这个思路。研究者针对机器人表现吃力的场景补充采集演示数据。在 22 项仿真任务中,这一方法比他们所对比的其他方法更高效地提升了表现。
但更好的人类演示,只是改进机器人的一种途径。英伟达的 SPARR 研究探索了另一种:让机器人在仿真中训练组装任务,再让它在真实硬件上练习以纠正错误,全程不需要人类演示。英伟达报告称,相比直接使用仿真训练出的系统,这种方法的成功率更高,任务完成时间大约缩短 30%。
那么 Kled 或 PrismaX 就没必要了吗?并非如此。对某一项具体任务而言,购买演示数据,可能比客户自己采集数据、或者靠仿真加练习来训练,更便宜、更快地改进机器人。但这两家公司的贡献者数量、录像时长,都无法说明它们能不能提供这种优势。
即便数据供应商拿下客户,也可能要等上几周才能收到钱。与此同时,贡献者要按时结算,下一个采集项目也需要资金。
其他行业早有办法填补这个缺口。比如花旗银行有一个项目,可以让沃尔玛的供应商提前收款:沃尔玛确认发票后,供应商可以请花旗在到期日之前付款,并接受一定的折扣作为提前拿钱的代价。等账单到期时,沃尔玛再把钱付给花旗。
这就是一笔已敲定的客户付款如何帮助供应商支撑后续工作。但对 AI 数据生意来说,有一个重大区别:在花旗那个例子里,买方已经核准了付款;而数据供应商的工作如果还在审核中,就可能面临被拒收。
要为此前那个更早的阶段融资,光知道买方有钱是不够的。放贷方必须搞清楚实验室订的是什么,以及供应商的录像是否满足这些要求。
Masterpiece 是一家试图服务这一细分市场的小型初创公司。它获得 Y Combinator 支持,称会在实验室审核供应商成果、处理付款的期间向数据供应商放贷。
Masterpiece 表示,在决定是否放贷前,它会核查供应商的发票、历史回款、数据质量和财务状况。通过审核的供应商可以在两到四天内拿到资金。据报道,它已获得超过 1000 万美元的授信额度用于放贷,并已放出 20 万美元贷款,年化收益率 24%。它还报告了超过 6500 万美元的已签署意向书——这只代表潜在业务,不等于已完成的贷款。目前我们还没有关于其借款方的公开信息。
现在还很早。这使它成为放贷机构探索这门生意的一个样本,但据此判断它们能多好地管控风险,还为时过早。
Masterpiece 表示,其放贷资金来自银行、私募信贷基金,以及一个名为 USDml 的稳定币资金池。加密用户可以往池中存入稳定币,目标年化回报为 8% 至 12%。这一回报并不保证。
Masterpiece 称,这个资金池帮助它满足「折价资本要求」(haircut capital requirements)。这通常指覆盖主贷方不愿出资的那部分贷款。处于这一层级的资金会先于主贷方承担损失。如果 USDml 真按这个方式运作,它的存款人承担的风险可能比信贷基金更大。
加密行业此前已经做过发票融资,也踩过一些熟悉的坑。2023 年,ConsolFreight 警告称,其在 Centrifuge 上 270 万美元借贷池中的最大借款方因一起法律纠纷面临清算,这让 MakerDAO 投进去的 184 万美元处于风险之中。把融资搬到链上,并没有消除借款方还不上钱的风险。
当融资发生在客户验收之前时,AI 数据又多了一层复杂因素。即使资金充裕的实验室,也会拒收质量检查不合格的录像。如果它只接受一批交付中的一部分,供应商拿到的钱可能少于预期,还贷就会变得困难。
便宜的数据可能很贵
用假数据训练的实验室不仅浪费算力,还可能得到一个更差的模型。所以这里每家公司卖的既是采集,也是审核。2023 年瑞士研究者的一项研究估计,亚马逊 Mechanical Turk 上用于人类任务的工作者中,多达 46% 在使用 AI 模型代做。手机让造假变得更难——拍一段自家厨房的第一人称视频,比生成一段文字摘要困难得多,但并非不可能。
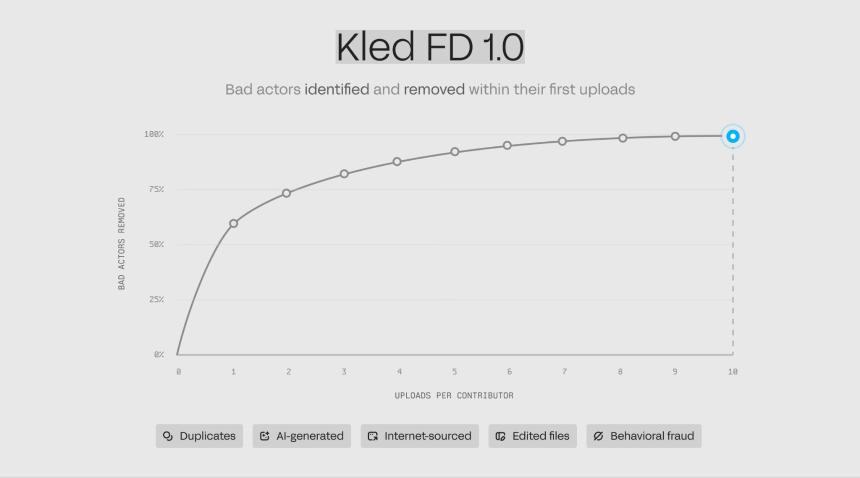
Kled 称其反欺诈模型 FD 1.0 能在不良行为者前 10 次上传内剔除其中的 98.4%,这一数据来自其内部测试。它还会为每个通过的文件在 Trace 上写一笔凭证——Trace 是由 The Data Foundation 运营的公共账本。我翻过 Kled 在 Trace 的审计页面:上面显示约 2.82 亿条记录,其中 99.2% 是图片、0.7% 是视频。东南亚占贡献的 74.5%,撒哈拉以南非洲占 22.7%,北美 2%,欧盟 0.4%。也就是说,Kled 目前的语料主要是来自两个地区的相册照片,距离机器人实验室想要的第一人称任务视频还差得很远。
一段录像也可能是不合格的训练材料。机器人可能从操控者身上学到不必要的停顿,或者因为它自己的摄像头视角与训练素材不同而表现不佳。真正重要的是,这份数据能否帮它把任务做得更好。PrismaX 描述了他们的测试方式:给 Physical Intelligence 的 π0.5 模型加训一批机器人抓取和放置物体的录像,然后改变光照和摄像头位置再做测试。
检验成果的方式各有不同。Sapien 要求数据标注者先押上一些代币,如果审核方认为提交不合格,这些代币会被扣掉。英伟达和 Lightwheel 则是在仿真环境里测试训练后的机器人表现如何。
我还没有找到一家同时被供应商和 AI 实验室广泛信任的独立审核方。我认为,能赢得这份信任的公司,靠审核数据收的钱可能比别家靠采集赚的还多。像 Masterpiece 这样的放贷方,在决定是否放款时可能也会依赖它的审核结果。
我认为这个行业正在给某种真实的东西定价,也正因如此,价格最终会降下来。Kled 或 PrismaX 为一间收拾好的房间付的钱,恰恰照出了机器人目前还做不到什么;而随着机器人变强,这个价钱会越来越便宜。
对大多数人来说,这眼下是一份不错的副业收入,但不足以拿来构建生活。